Как секвенатор выбирает нужную ДНК прямо во время чтения
При поиске определённого гена большая часть молекул в образце может оказаться неинтересной для задачи. В нанопоровом секвенировании выбор можно сделать уже после начала чтения: программа распознаёт молекулу и решает, продолжать работу или освободить пору. Разберём механизм adaptive sampling и цену такой избирательности.
Выбор происходит после захвата молекулы
Нанопора представляет собой канал, через который проходит молекула ДНК. Изменения электрического сигнала позволяют восстанавливать её последовательность. Для избирательного чтения нужно быстро получить начало последовательности, сопоставить его с опорным геномом и принять решение, пока молекула ещё находится в поре.
Если молекула не соответствует выбранной цели, прибор может изменить направление напряжения и вытолкнуть её. Пора получает шанс захватить следующую молекулу. При совпадении чтение продолжается. Этот подход называют adaptive sampling, адаптивным отбором. Смысл длинных чтений и их отличия от коротких отдельно объясняет статья о двух способах секвенирования.
В документации Oxford Nanopore описаны режимы обогащения и исключения. В первом сохраняют чтения целевых участков, во втором отвергают указанные последовательности, например ДНК хозяина в смешанном образце. Решение зависит от поставленной задачи и подготовленного референса, опорной последовательности для сопоставления.
Что показала работа readfish
Payne и соавторы разработали readfish, программный набор для управления избирательным чтением. Ключевой шаг состоял в быстром переводе сигнала в последовательность с помощью графического процессора и последующем выравнивании. Так авторы смогли работать с большими геномами, не ограничиваясь небольшими справочными наборами.
В работе демонстрировали обогащение отдельных хромосом человека, целевых генных панелей и последовательностей редких организмов в смеси. Это примеры управления тем, на какие молекулы расходуется время прибора. Они сами по себе не устанавливают диагностическую эффективность для любой болезни или любого клинического образца.
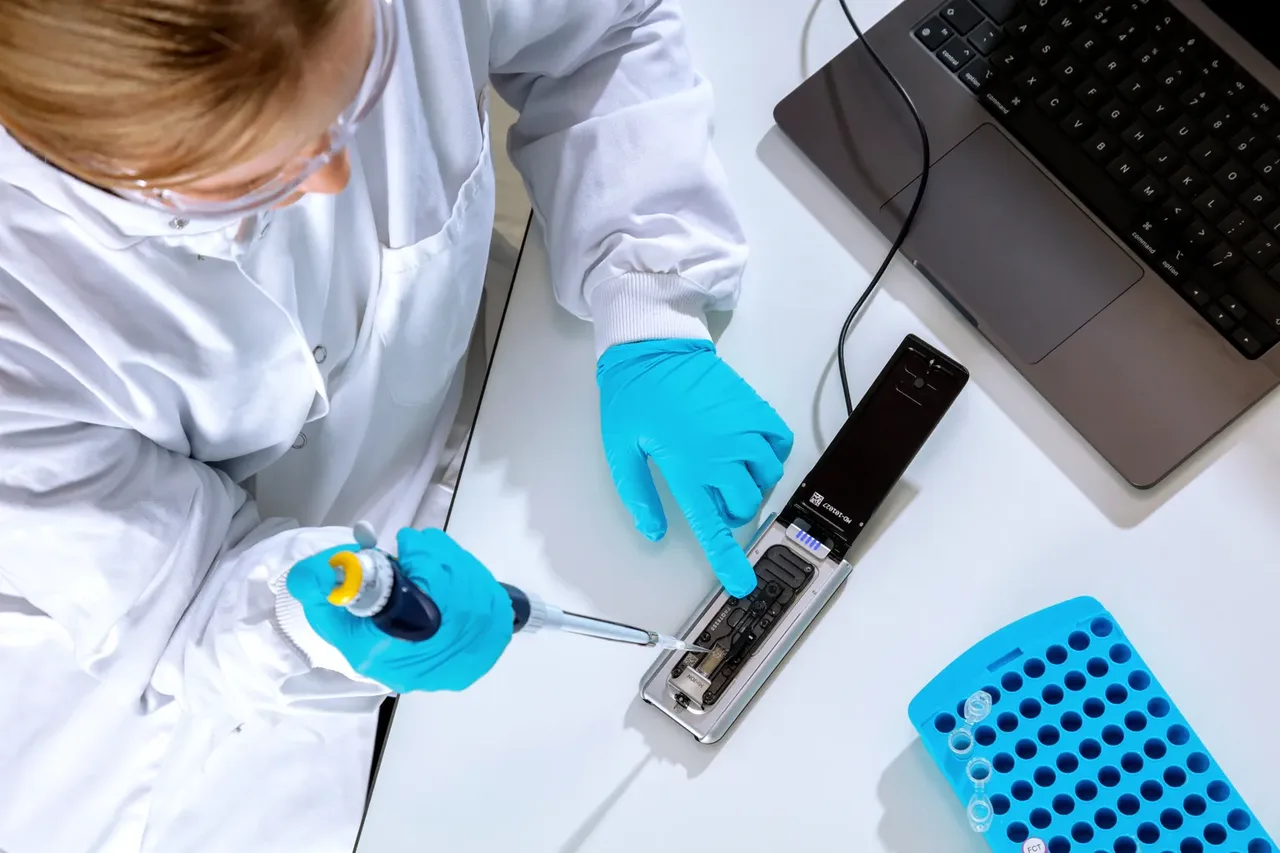
На обложке показан современный MinION из пресс-материалов производителя. Эксперименты readfish описывают свой аппаратный и программный контекст; фотография не означает, что именно этот прибор использовали в исходной работе.
Почему отбрасывание не бывает бесплатным
Решение требует времени и вычислительной мощности. Начало нецелевой молекулы уже прочитано, даже если её затем отвергают. Авторы также наблюдали, что частое отбрасывание может снижать общий выход секвенирования. Поэтому более высокая доля целевых данных и большее суммарное количество прочитанной ДНК являются разными результатами.
В метагеномике авторы выделяли сокращение времени до ответа как важное преимущество. Однако состояние образца и блокирование пор влияют на то, удастся ли получить ожидаемое обогащение. О том, какой клинический вопрос можно задать смешанному образцу, рассказывает материал о метагеномном секвенировании.
Есть и зависимость от референса. Инструкция производителя предупреждает, что неполный набор опорных последовательностей способен приводить к ошибочному сопоставлению и пропуску нецелевых молекул. Требуется проверить сам список целей, а не только включить режим в программе.
Практический вопрос к сообщению об adaptive sampling поэтому звучит конкретно: что отбирали, по какому референсу, с каким контролем и сколько целевых данных получили за сравнимое время? Ответ показывает, где метод помогает задаче. Само название технологии этого ответа не даёт.
Matthew Loose, один из авторов readfish, сообщил, что ранее получал бесплатные проточные ячейки и реагенты, а также компенсации расходов на выступления на мероприятиях Oxford Nanopore Technologies. Эти связи следует учитывать вместе с методами, контрольными экспериментами и опубликованными данными.