Life
Модель подвижности после переломов позвоночника сократила крайние ошибки, но часто пропускала малоподвижных пациентов
Опубликовано на USB.RU:
Во внутренней проверке на 158 пациентах двухэтапная модель реже путала крайние категории, чем простой прогноз по подвижности до перелома. Это сопровождалось низкой чувствительностью к самой малоподвижной группе; внешней проверки пока нет.
Исследователи из Лейпцига оценили прогноз подвижности при выписке после остеопоротических переломов грудного и поясничного отделов позвоночника. В проспективную когорту одной больницы включили 158 пациентов от 65 лет. Для большинства показателей брали данные около поступления; для витамина D допускали анализ вплоть до выписки. Авторы стремились к раннему прогнозу, но это исключение важно при оценке его применимости.
Физиотерапевты оценивали подвижность при выписке. Низкая категория означала ходьбу менее 50 метров, только перемещения между поверхностями или постельный режим; средняя соответствовала 50-500 метрам, высокая превышению 500 метров либо способности подниматься по лестнице. Границы задали заранее по клиническому согласованию; специально валидированной для этой группы классификации нет.
Один компонент модели оценивал вероятность высокой подвижности, другой низкой. Затем отдельное правило присваивало итоговую категорию и оставляло промежуточную группу, если условия для крайних не выполнялись. Сравнением служила логистическая модель только с подвижностью до перелома. Для неё не применяли аналогичное правило порогов, поэтому результат нельзя приписать одному лишь машинному обучению.
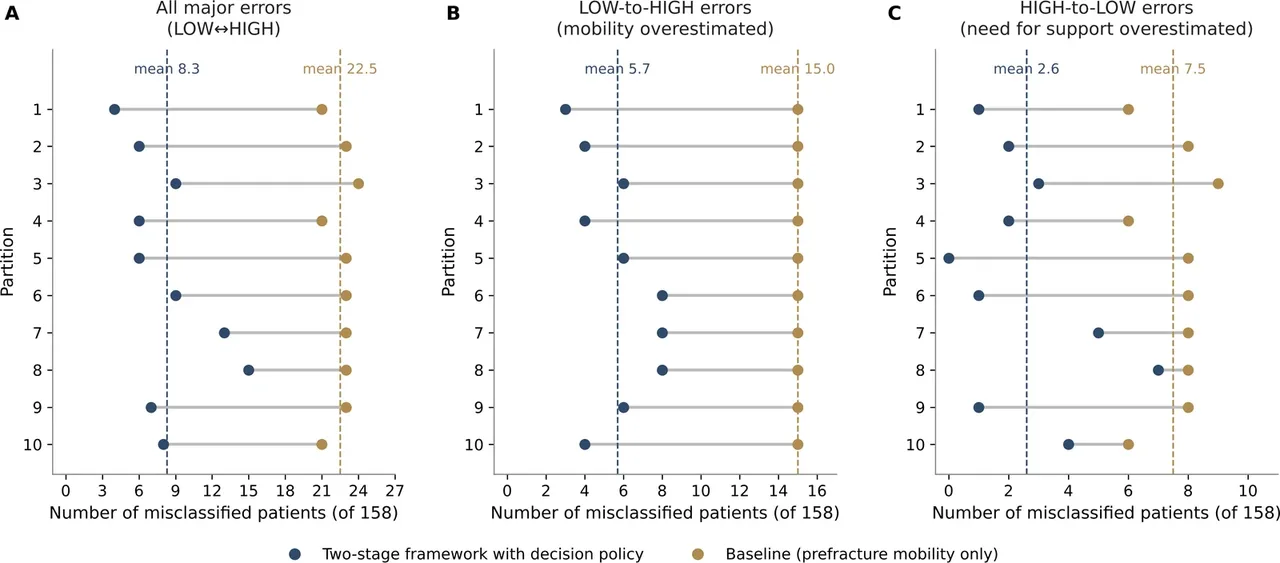
Главный результат лучше читать по вложенной перекрёстной проверке, где пороги выбирали внутри обучающих частей. Её повторили на десяти разбиениях одной и той же когорты. Среднее число ошибок между низкой и высокой категориями составило 8,3 против 22,5 у простой модели. Это средние числа ошибок на разбиение, а не новые пациенты или отдельные больницы.
При этом модель правильно распознавала в среднем лишь чуть более одной десятой пациентов самой малоподвижной группы. Полнота распознавания составляла 0,117 против 0,407 у простой модели; единица на этой шкале означала бы распознавание всей группы. Macro-F1, усредняющий качество по классам, равнялся 0,388. Модель уменьшала крайние ошибки ценой частого назначения средней категории. Её нельзя описывать как надёжный способ обнаружить всех, кому нужна помощь после выписки.
В первоначальном анализе не было ошибок, когда высокую подвижность принимали за низкую. При вложенной проверке они появились в девяти из десяти разбиений. Поэтому работа показывает сокращение таких ошибок, но не их устранение.
Внешней проверки в другой больнице не было. Гиперпараметры моделей подбирали на этой же когорте и не перенастраивали внутри вложенного цикла, поэтому дополнительный оптимизм оценки остаётся возможным. Небольшая выборка, местный маршрут реабилитации и отсутствие данных об осложнениях, боли и социальной поддержке ограничивают переносимость. Улучшение исходов пациентов при использовании прогноза не проверяли.
Чем внутренняя проверка отличается от испытания на новых данных, объясняет статья «Как проверяют диагностическую ИИ-модель: внешняя выборка и утечка данных на конкретном примере». Почему показатель качества модели ещё не доказывает пользу для пациента, разбирает материал «Биомаркер и клиническая польза: различие конечных точек на конкретном примере».
Проект поддержан программой eHealthSax Саксонского банка развития. Авторы заявили об отсутствии конфликтов интересов. Они отдельно раскрыли использование языковых моделей для редактирования текста и помощи с кодом, сохранив ответственность за проверку анализа; сырые данные пациентов публично не размещены.