AI-модели
Astra набрала 66,7% в лабораторном тесте OpenAI, но всё ещё спорит с данными
Опубликовано на USB.RU:
Модель замечает неверный антибиотик на чашке, но может выбрать не те колонии и отбросить неудобное наблюдение. Новый BioBasicsBench проверяет то, что не видно в обычной викторине по биологии.
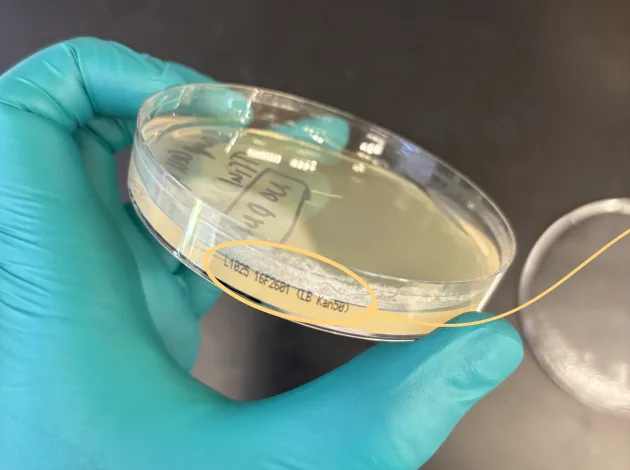
OpenAI и биотехнологическая компания Ligo представили BioBasicsBench - тест на разбор сырых лабораторных данных. В нём агенту нужно понимать снимки чашек с колониями, гели, изображения микроскопа и показания приборов, замечать ошибки опыта и признавать, когда доказательств недостаточно. Это проверка повседневной работы с результатами экспериментов, а не викторина по биологии.
На максимальном общем для сравниваемых моделей уровне рассуждений xhigh GPT-6 Astra получила в среднем 66,7% доступных баллов против 43,8% у GPT-5.6 Sol. Но собственные примеры OpenAI показывают предел этого роста: модель может увидеть проблему и всё равно выбрать вывод, который противоречит данным. Высокий результат в таблице ещё не делает агента надёжным лабораторным помощником.
Не картинки из статьи, а следы настоящего опыта
В BioBasicsBench собрали 100 задач из пяти областей: работа с белками, визуализация и цитометрия, количественные измерения и анализы, методы работы с нуклеиновыми кислотами и молекулярное клонирование. Учёные составили вопросы по данным собственных экспериментов и подготовили критерии оценки. Каждую задачу проверили другой специалист Ligo, внешний учёный с докторской степенью и затем снова внутренняя команда.
Агентам показывали исходные фотографии, стопки микроскопических изображений, видеозаписи процедур, результаты секвенирования и экспорты приборов, а не только аккуратные иллюстрации для публикаций. Задача может одновременно требовать биологических знаний, чтения изображения, проверки протокола и поиска ошибки. Поэтому категории навыков и типов входных данных пересекаются.
Ответ оценивают по отдельным пунктам: правильности вывода, измерениям, объяснению или признанию недостаточности данных. Значение 66,7% означает среднюю долю полученных баллов, а не то, что модель полностью решила такую долю задач. Частично верный разбор тоже получает часть баллов.
Astra стала лучше замечать неправильный контроль
В одном опыте GPT-5.6 Sol не увидела колоний на отрицательном контроле и использовала это для вывода об эксперименте. Astra заметила, что на чашке указан не тот антибиотик: канамицин вместо ампициллина. Такой контроль нельзя считать надёжным, и небольшая надпись на краю чашки меняет смысл всей картинки.
В другом примере яркость красителя казалась признаком гибели клеток. Astra учла, что каналы детекции двух красителей перекрываются и сигнал может смешиваться, поэтому попросила корректные контрольные измерения. А в серии микроскопических кадров она распознала съёмку на разной глубине, вместо того чтобы объяснять исчезновение клеток биологическим процессом.
Увидеть факт недостаточно, нужно дать ему изменить ответ
Ошибки новой модели тоже показаны открыто. В задаче с колониальной ПЦР Astra правильно различила группы полос, но неверно связала их с исходной и новой плазмидой. Привычное предположение о размере продукта перевесило сравнение с контролями, и модель предложила не те колонии для дальнейшей работы.
В микроскопическом изображении она заметила и тёмные, и светлые вакуоли, но сохранила в итоговом ответе только удобное обобщение о тёмных. Между тем контраст мог меняться с фокусом. В задаче подсчёта колоний модель пропускала видимые объекты, объединяла соседние и отмечала пустой агар; итоговый счёт был примерно на 12% выше эталона.
Такие ошибки важны не только для красивого объяснения. Неверный контроль меняет вывод об успехе опыта, неправильный выбор колоний ведёт к работе с другой плазмидой, а завышенный подсчёт колоний искажает оценку эффективности введения ДНК в клетки. Проверять нужно весь путь от наблюдения к решению, а не только финальную формулировку.
Один тест, разные затраты на рассуждение
OpenAI сравнила семь моделей в 37 сочетаниях модели и уровня рассуждений. Для каждой настройки сделали по пять попыток на каждой из 100 задач, всего 18 500 результатов. При xhigh GPT-6.1 Sol получила 62,0% баллов, GPT-6 Luna - 38,3%, GPT-5.5 - 35,4%, GPT-5.4 - 33,2%, а GPT-5.2 - 31,2%. Это оценки в условиях теста от его разработчиков, не независимая сертификация лабораторной надёжности.
Улучшение не сводится к более длинному ответу: при xhigh Astra в среднем выдавала 4704 токена на задачу, а GPT-5.6 Sol - 9099. Эти числа описывают объём выхода, не цену всего опыта и не время работы. Смысл BioBasicsBench в другом: измерять, способен ли агент связать изображение, контроль и контекст в обоснованный вывод, включая отказ от вывода, для которого данных нет.
Это другой срез качества по сравнению с поиском уязвимостей в Linux или командной работой Claude в EVE. Во всех случаях полезность агента определяется не количеством уверенных ответов, а тем, замечает ли он ограничения данных и меняет ли действия после проверки.